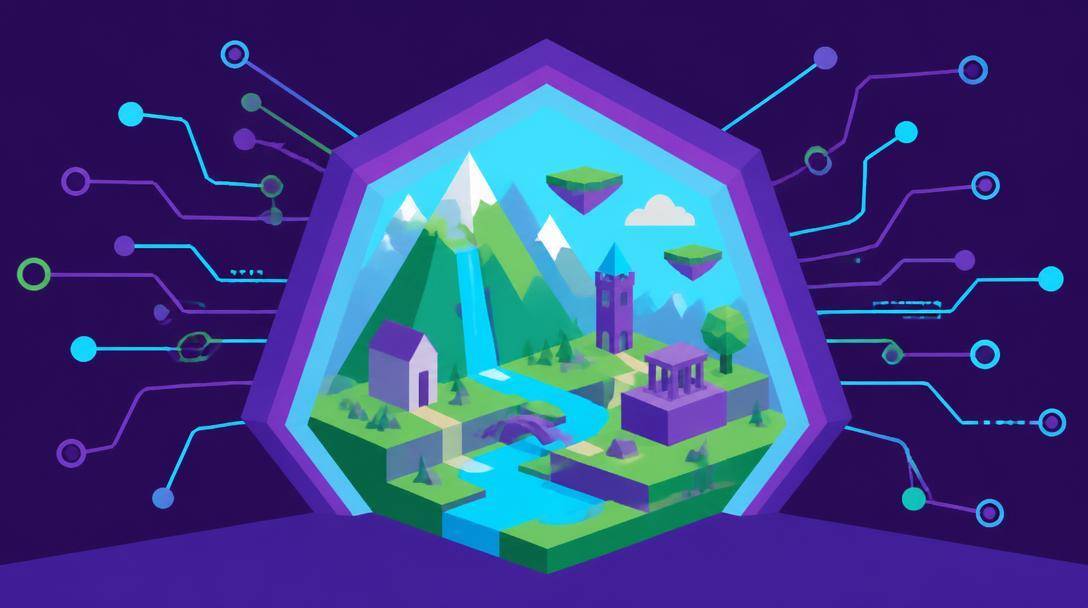
Google ha annunciato il 19 novembre 2026 la disponibilità di Genie 4 attraverso la Gemini API e Google AI Studio, aprendo agli sviluppatori l’accesso a un modello di intelligenza artificiale capace di generare ambienti digitali esplorabili e modificabili in tempo reale. La novità riguarda la possibilità di integrare queste simulazioni all’interno di applicazioni e prototipi software, superando la fase iniziale di sperimentazione riservata a un numero limitato di utilizzatori.
Genie 4 di Google permette di creare mondi interattivi a partire da descrizioni testuali, immagini di riferimento o dalla combinazione dei due elementi. Gli ambienti vengono generati con risoluzione di 1280 × 720 pixel, a 24 fotogrammi al secondo, accompagnati da audio stereofonico sincronizzato. Durante l’esplorazione è possibile intervenire sulla scena attraverso comandi da tastiera oppure nuove istruzioni in linguaggio naturale.
La disponibilità delle API introduce una prospettiva concreta per lo sviluppo di esperienze interattive, la visualizzazione di progetti spaziali e la sperimentazione di ambienti destinati all’addestramento di sistemi autonomi. Restano tuttavia limiti tecnici significativi, soprattutto nella durata delle sessioni e nella capacità di mantenere invariati gli oggetti quando escono temporaneamente dall’inquadratura.
Dalla presentazione di ottobre all’accesso per gli sviluppatori
Il percorso di Genie 4 è iniziato il 27 ottobre 2026, quando Google DeepMind ha presentato il nuovo modello dedicato alla simulazione interattiva. In quella occasione l’accesso era limitato a un gruppo di sperimentatori selezionati, mentre la distribuzione attraverso Project Genie e gli strumenti per sviluppatori veniva indicata come un passaggio successivo.
Il 18 novembre Google ha introdotto Genie 4 nella versione aggiornata di Project Genie, l’ambiente sperimentale che consente di creare ed esplorare mondi virtuali attraverso il browser. L’accesso è stato avviato per gli abbonati Google AI Ultra idonei, mentre per gli utenti Google AI Pro è stata prevista una lista d’attesa.
Il giorno successivo è arrivato l’annuncio destinato agli sviluppatori.
Dal 19 novembre Genie 4 è accessibile attraverso la Interactions API di Gemini e Google AI Studio, con documentazione tecnica, applicazioni iniziali di esempio e strumenti per sperimentare le funzionalità del modello.
La distinzione è rilevante. Project Genie offre un’interfaccia attraverso la quale creare e visitare ambienti generati dall’intelligenza artificiale. Le API consentono invece di incorporare il sistema in applicazioni sviluppate autonomamente, gestendo le sessioni, trasmettendo comandi e ricevendo i contenuti audiovisivi prodotti durante l’interazione.
L’annuncio riguarda quindi una nuova modalità di accesso a una tecnologia già presentata, non il debutto di un modello differente.
Come vengono generati e modificati gli ambienti virtuali
La caratteristica principale di Genie 4 di Google è la generazione continua dell’ambiente in risposta alle azioni dell’utilizzatore.
I sistemi tradizionali di generazione video producono normalmente sequenze con una durata definita. Genie 4 utilizza invece un processo che costruisce progressivamente le immagini della scena, tenendo conto degli spostamenti e degli interventi effettuati durante la sessione.
La creazione può iniziare con una descrizione testuale di un luogo, delle sue caratteristiche visive e dell’atmosfera desiderata. In alternativa si può utilizzare un’immagine di riferimento per orientare l’aspetto iniziale dell’ambiente.
Una volta avviata la simulazione, i comandi da tastiera permettono di muoversi nello spazio virtuale. Le istruzioni testuali possono modificare il tempo atmosferico, l’illuminazione, gli oggetti presenti e gli avvenimenti che si svolgono nella scena.
Un ambiente inizialmente illuminato dal sole potrebbe, per esempio, essere trasformato durante l’esplorazione attraverso una richiesta di pioggia o di cambiamento delle condizioni luminose. Si tratta di un impiego coerente con le funzioni documentate, senza richiedere la ricostruzione manuale dell’intera sequenza audiovisiva.
Il modello integra inoltre la generazione nativa dell’audio, comprendente rumori ambientali, effetti sonori e dialoghi. I contenuti sonori vengono prodotti insieme alle immagini e possono adattarsi all’evoluzione della simulazione.
L’architettura sfrutta anche le capacità dei modelli della famiglia Gemini. Google DeepMind ha descritto il contributo di Gemini Omni nella rappresentazione dell’aspetto e del comportamento degli ambienti, affiancato da altri modelli Gemini per sostenere la coerenza delle simulazioni.
Questo intervento contribuisce alla continuità della scena, ma non equivale alla presenza di un motore fisico deterministico o di una rappresentazione tridimensionale permanente.
Gemini API e Google AI Studio: cosa cambia per chi sviluppa software
La documentazione tecnica identifica Genie 4 attraverso il modello models/genie-4, utilizzabile con la versione v1beta della Interactions API.
Il sistema prevede la creazione di una sessione interattiva, l’inizializzazione dell’ambiente e l’apertura di una connessione attraverso la quale inviare comandi e ricevere i contenuti generati.
Sono supportate due modalità principali di comunicazione: WebRTC e WebSocket.
WebRTC è indicato soprattutto per le applicazioni interattive eseguite nel browser, perché consente di ricevere flussi audiovisivi con una gestione della latenza adatta alle interazioni in tempo reale. WebSocket può essere utilizzato nei programmi Python, nei servizi Node.js e nelle applicazioni che richiedono una gestione personalizzata dei dati ricevuti.
Google mette a disposizione SDK per Python e JavaScript, consentendo agli sviluppatori di lavorare con strumenti già diffusi nella realizzazione di applicazioni web e servizi software.
In Google AI Studio sono disponibili un ambiente interattivo e applicazioni iniziali attraverso le quali sperimentare il modello.
La procedura documentata per l’integrazione attraverso API richiede una chiave Gemini abilitata al livello a pagamento. L’applicazione crea una sessione, stabilisce una connessione, invia le istruzioni iniziali e gestisce successivamente i comandi dell’utilizzatore.
Un elemento riguarda la sicurezza delle credenziali. Nelle applicazioni web la chiave API permanente deve rimanere sul server, mentre il browser può utilizzare un token temporaneo associato alla singola sessione.
Anche la chiusura deve essere gestita esplicitamente. Interrompere la visualizzazione o chiudere una scheda del browser non garantisce l’arresto immediato della generazione sul server. La documentazione prevede una specifica operazione di completamento della sessione, necessaria anche per interrompere correttamente la fatturazione.
Simulazioni, videogiochi e prototipazione: gli impieghi possibili
L’accesso alle API potrebbe rendere Genie 4 di Google particolarmente interessante nelle prime fasi di progettazione di applicazioni interattive.
Nello sviluppo dei videogiochi, per esempio, la generazione di ambienti esplorabili può servire a verificare rapidamente l’impostazione visiva di un’ambientazione, sperimentare variazioni atmosferiche oppure valutare la percezione di uno spazio durante il movimento.
Il vantaggio potenziale riguarda la riduzione del lavoro necessario per ottenere una prima rappresentazione interattiva di un’idea.
Questo non significa che Genie 4 possa sostituire integralmente un motore grafico tradizionale. Le applicazioni videoludiche richiedono spesso geometrie controllabili, gestione affidabile delle collisioni, comportamenti riproducibili e regole persistenti. Sono caratteristiche che non possono essere considerate automaticamente garantite dalla generazione probabilistica delle immagini.
Un secondo ambito riguarda la progettazione spaziale.
Architetti, progettisti e sviluppatori di applicazioni immersive potrebbero utilizzare ambienti generativi per esplorare rapidamente configurazioni visive e scenari preliminari. La possibilità di modificare una scena durante l’esplorazione può essere utile nelle attività creative e nella comunicazione di un concept.
Resta indispensabile distinguere queste rappresentazioni dalle simulazioni tecniche utilizzate per verificare misure, proprietà dei materiali o prestazioni strutturali. Genie 4 non viene documentato come uno strumento di progettazione ingegneristica certificato.
Google indica inoltre l’addestramento di robot e agenti di intelligenza artificiale tra le possibili applicazioni dei modelli di simulazione del mondo.
L’interesse scientifico deriva dalla possibilità di costruire ambienti nei quali un sistema autonomo possa affrontare situazioni differenti. Un agente potrebbe, in prospettiva, essere sottoposto a scenari visivi variabili prima di essere sperimentato in condizioni operative.
Per utilizzare questi ambienti come strumenti di addestramento affidabili servono però ulteriori verifiche sulla correttezza dei comportamenti simulati, sulla ripetibilità delle condizioni e sulla corrispondenza con il mondo fisico.
La disponibilità di Genie 4 attraverso le API rappresenta quindi un’opportunità di sperimentazione, senza dimostrare automaticamente la sua idoneità a ogni applicazione industriale.
I limiti tecnici: sessioni di due minuti e oggetti non sempre persistenti
La documentazione pubblicata da Google chiarisce diversi vincoli che incidono direttamente sull’utilizzo professionale del modello.
Le sessioni interattive attraverso la Gemini API hanno una durata massima di 120 secondi. La stabilità visiva può inoltre peggiorare dopo circa 60-90 secondi di generazione continua.
Il problema più significativo riguarda la permanenza degli oggetti.
Genie 4 non mantiene necessariamente una rappresentazione tridimensionale completa e stabile dell’intero ambiente. Il modello lavora su una finestra temporale di informazioni visive, generando progressivamente la scena.
Quando un oggetto rimane fuori dall’inquadratura per diversi secondi, potrebbe modificarsi o riapparire in una posizione differente. Anche un movimento completo della visuale può determinare cambiamenti negli elementi dell’ambiente.
Questa caratteristica limita l’utilizzo del modello nei progetti che richiedono una geometria rigorosamente persistente.
Esistono inoltre differenze nei tempi di risposta. I normali comandi di movimento presentano una latenza indicativa compresa tra 0,2 e 0,5 secondi, mentre le modifiche richieste attraverso istruzioni testuali possono richiedere circa uno o due secondi prima di diventare visibili.
L’avvio iniziale dell’ambiente può richiedere indicativamente da cinque a nove secondi.
La risoluzione è fissata a 720p, con rapporto 16:9 e frequenza di 24 fotogrammi al secondo. Non sono previste, nella documentazione consultata, impostazioni alternative per video verticali o frequenze di aggiornamento personalizzate.
Altre limitazioni riguardano la precisione del contenuto generato. Scritte, orologi, strumenti di misura e quantità esatte di oggetti possono alterarsi durante la simulazione.
Il modello non supporta inoltre l’acquisizione diretta di flussi live da microfono o webcam, l’esecuzione di chiamate a strumenti esterni, l’integrazione con Google Search come fonte di informazioni durante la sessione o il ripristino di un’interazione già completata.
Sono vincoli che rendono necessario progettare le applicazioni in funzione delle caratteristiche effettive della tecnologia.
Costi e disponibilità geografica dell’accesso alle API
L’utilizzo professionale di Genie 4 di Google richiede anche una valutazione dei costi di generazione.
La documentazione della Gemini API indica una fatturazione basata sui token video prodotti, con un consumo di 240 token per fotogramma. Alla frequenza prevista di 24 fotogrammi al secondo, il totale raggiunge 5.760 token al secondo.
Il costo indicativo riportato da Google è di circa 0,10 dollari per secondo di generazione, comprensivo dell’audio stereofonico.
Una sessione di 60 secondi comporterebbe quindi un costo indicativo di circa 6 dollari, mentre due minuti raggiungerebbero circa 12 dollari, considerando la tariffa dichiarata e senza eventuali variazioni o ulteriori condizioni di fatturazione.
Questi valori rendono particolarmente rilevante la gestione delle sessioni nelle applicazioni che prevedono numerosi utilizzatori contemporanei.
Per quanto riguarda l’infrastruttura geografica, Google indica che il servizio viene erogato da centri dati situati negli Stati Uniti, nell’Europa occidentale e in Giappone.
Le condizioni di latenza migliori sono previste per collegamenti provenienti dal Nord America, dall’Europa occidentale e centrale e dall’Asia orientale. Gli utilizzatori collegati da regioni più distanti potrebbero incontrare tempi di risposta superiori e una riduzione della fluidità.
La presenza di infrastrutture europee non costituisce, da sola, una garanzia di accesso per qualunque account situato nell’Unione europea. L’effettiva utilizzabilità delle API dipende anche dall’idoneità del progetto, dall’abilitazione della fatturazione e dalle condizioni applicabili all’account.
La documentazione consultata non fornisce un elenco esaustivo dei singoli Paesi abilitati specificamente per Genie 4. Non sarebbe quindi corretto dedurre un accesso universale dalla sola presenza del modello in Google AI Studio.
Sicurezza dei contenuti e identificazione delle simulazioni artificiali
La distribuzione di strumenti capaci di generare ambienti audiovisivi realistici introduce anche questioni legate all’identificazione dei contenuti e al loro utilizzo.
Google ha previsto l’integrazione di SynthID negli output di Genie 4, applicando un sistema di marcatura digitale impercettibile progettato per agevolare il riconoscimento dei contenuti prodotti mediante intelligenza artificiale.
La marcatura riguarda i contenuti generati, mentre i sistemi di controllo intervengono anche sugli input.
La documentazione descrive filtri che possono impedire l’avvio di una simulazione oppure interrompere una sessione quando vengono rilevati contenuti non consentiti. Tra le situazioni potenzialmente soggette a blocco figurano richieste e immagini di riferimento contenenti persone reali identificabili, personaggi pubblici o proprietà intellettuali protette.
Questi controlli incidono sulle possibilità di impiego del modello, soprattutto nei progetti commerciali che utilizzano immagini, marchi o personaggi riconoscibili.
Non rappresentano però una garanzia generale sulla liceità di ogni contenuto prodotto. Le applicazioni destinate al pubblico devono comunque considerare la provenienza dei materiali utilizzati, i diritti sulle immagini e le condizioni contrattuali del servizio.
La disponibilità attraverso API amplia inoltre la responsabilità degli sviluppatori nella gestione dell’accesso, dei costi e delle modalità con cui gli utenti possono generare contenuti.
Il rapporto con gli strumenti tradizionali di sviluppo
L’arrivo di Genie 4 di Google negli strumenti per sviluppatori introduce una distinzione interessante tra due modi di costruire ambienti digitali.
Nei motori grafici tradizionali, lo sviluppatore definisce oggetti, geometrie, materiali e regole di comportamento. L’ambiente viene successivamente rappresentato attraverso procedure che mantengono una struttura controllabile.
Un modello generativo come Genie 4 produce invece una rappresentazione audiovisiva in evoluzione, condizionata dalle istruzioni e dalle interazioni ricevute.
La differenza emerge soprattutto quando occorre ripetere esattamente un’azione, conservare la posizione di un oggetto o verificare una specifica proprietà fisica.
Le simulazioni generative possono accelerare l’esplorazione di idee, mentre i motori tradizionali rimangono necessari quando servono controllo strutturale e comportamenti deterministici.
Una possibile area di sviluppo riguarda l’integrazione dei due approcci: utilizzare la generazione interattiva per valutare scenari e ambientazioni preliminari, trasferendo successivamente gli elementi selezionati in strumenti che permettano una realizzazione tecnica controllata.
Non si tratta di una funzione di esportazione automatica dei mondi generati già documentata per Genie 4, ma di una possibile organizzazione del lavoro.
La novità del 19 novembre consiste proprio nella possibilità di iniziare a sperimentare queste applicazioni attraverso interfacce software, senza limitarsi all’esperienza predefinita di Project Genie.
La documentazione disponibile permette già di conoscere le condizioni operative principali: connessioni in tempo reale, sessioni brevi, fatturazione proporzionale alla generazione e limitazioni nella persistenza visiva.
Per gli sviluppatori, la verifica decisiva sarà quanto queste caratteristiche consentiranno di realizzare prototipi effettivamente utilizzabili e riproducibili, soprattutto quando un ambiente generato dovrà interagire con componenti software tradizionali.